
Le Google Knowledge Graph est la base de connaissances interne de Google qui lui permet de reconnaître des entités — personnes, organisations, lieux, œuvres — et de répondre directement aux requêtes factuelles sans renvoyer l’utilisateur vers un site tiers. Pour un SEO ou un développeur, cela se traduit par une réalité concrète : si Google reconnaît votre entité, une fiche info (Knowledge Panel) peut apparaître dans les résultats, augmentant la visibilité et le taux de clic. Si Google ne la reconnaît pas, aucun levier de revendication ne fonctionne.
Les leviers directs restent limités mais réels : déployer des données structurées au format JSON‑LD via le vocabulaire schema.org, créer ou enrichir une entrée Wikidata, et revendiquer la fiche info via le processus officiel Google. Ce guide couvre chacun de ces leviers en détail, avec des exemples de code et une checklist priorisée adaptée au contexte francophone.
Table des matières
- Comment fonctionne le Google Knowledge Graph ?
- Quelles sources alimentent le Knowledge Graph ?
- Quelle est l’architecture technique du Knowledge Graph ?
- Comment revendiquer et gérer votre fiche info Google ?
- Comment utiliser la Knowledge Graph Search API ?
- Quelles sont les limites et critiques du Knowledge Graph ?
- Checklist technique pour améliorer la reconnaissance de votre entité
- Points clés
- Le Knowledge Graph vu de l’agence : ce que les professionnels sous-estiment
- Zetaplus vous accompagne sur la visibilité de votre entité
- Ressources officielles et lectures recommandées
- Questions fréquentes
Comment fonctionne le Google Knowledge Graph ?
Origine et évolution : de Freebase aux milliards d’entités
Google a annoncé le Knowledge Graph en mai 2012 avec une formule restée célèbre : passer des strings (chaînes de caractères) aux things (choses réelles). L’idée était de ne plus traiter une requête comme une suite de mots à faire correspondre à des documents, mais de comprendre ce que l’utilisateur cherche vraiment — une personne, un lieu, un concept.
À l’origine, le projet s’appuyait largement sur Freebase, une base de données collaborative rachetée par Google en 2010. Freebase a ensuite été progressivement migrée vers Wikidata à partir de 2014, avant d’être fermée en 2016. Depuis, le graphe a atteint une échelle considérable), avec plusieurs milliards d’entités et des centaines de milliards de faits référencés.
« Le Knowledge Graph nous permet de répondre à des questions comme ‘Quel est le poids de la Tour Eiffel ?’ ou ‘Quels films a réalisé ce réalisateur ?’ — directement dans les résultats, sans que l’utilisateur ait besoin de cliquer. »
Google, annonce officielle 2012
Ce qu’est une entité dans ce contexte
Une entité est un objet du monde réel auquel Google attribue un identifiant unique interne. Elle possède des propriétés (nom, date de naissance, secteur d’activité) et des relations avec d’autres entités (fondateur de, situé à, membre de). La définition académique proposée par Ehrlinger et Wöß précise qu’un graphe de connaissances intègre des ontologies formelles pour structurer ces relations — ce qui distingue le Knowledge Graph d’un simple index de pages.
La distinction entre le graphe interne et la fiche info visible est fondamentale. Une entité peut exister dans le graphe sans générer de Knowledge Panel dans les résultats. La fiche n’est que la surface émergée : elle apparaît quand Google juge que l’entité est suffisamment connue et que les données sont assez fiables pour être affichées directement.
Quelles sources alimentent le Knowledge Graph ?
Sources publiques : Wikipedia et Wikidata
Wikipedia reste la source encyclopédique la plus influente. Google en extrait des faits structurés — infoboxes, catégories, liens inter-articles — pour alimenter les propriétés d’une entité. Wikidata joue un rôle complémentaire mais distinct : c’est une base de données structurées, lisible par des machines, où chaque entité reçoit un identifiant unique appelé QID (par exemple, Q90 pour Paris). Ces QIDs servent de pivot pour relier les informations provenant de sources différentes.
Selon la documentation officielle Google, le Knowledge Graph combine des sources publiques comme Wikipedia et Wikidata avec des sources sous licence et des données issues du web public.
Sources privées et licenciées
Pour certaines catégories de données — résultats sportifs en temps réel, cours de bourse, météo, horaires de films — Google s’appuie sur des flux de données sous licence fournis par des partenaires tiers. Ces données ne sont pas accessibles via la Knowledge Graph Search API et ne peuvent pas être influencées par des actions SEO classiques.
| Type de source | Exemples | Modifiable par l’entité ? |
|---|---|---|
| Encyclopédique ouverte | Wikipedia, Wikidata | Oui, via contribution |
| Web public structuré | Pages avec schema.org | Oui, via JSON‑LD |
| Licences privées | Données sportives, boursières | Non |
| Contributions officielles | Revendication de fiche | Oui, via Google Support |
Risques liés aux sources
Les panels peuvent afficher des informations sans attribution claire à une source précise, ce qui rend difficile la correction d’une erreur. Un fait incorrect présent dans plusieurs sources concordantes sera considéré comme fiable par le système, même s’il est faux. Les biais de représentation — notamment pour des entités moins documentées en français — constituent un risque réel pour les marques et personnalités francophones.
- Introducing the Knowledge Graph: things, not strings
- How Google’s Knowledge Graph works – Knowledge Panel Help
- Google’s Knowledge Graph and Knowledge Panels
- Knowledge Graph (Google)
- Graphe de connaissances
- schema.org
- json-ld.org
- Wikidata
Quelle est l’architecture technique du Knowledge Graph ?
Formats et standards : schema.org et JSON‑LD
Google recommande officiellement JSON‑LD comme format pour intégrer des données structurées dans les pages web. Le vocabulaire de référence est schema.org, qui définit les types (Organization, Person, LocalBusiness, etc.) et leurs propriétés (name, url, sameAs, description).
Voici un exemple minimal pour déclarer une organisation :
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Zetaplus",
  "url": "https://zetaplus.eu",
  "sameAs": [
    "https://www.wikidata.org/wiki/Q[QID]",
    "https://www.linkedin.com/company/zetaplus"
  ],
  "description": "Agence IA & Growth basée à Paris, spécialisée en production de contenu IA et social media growth."
}
La propriété sameAs est particulièrement importante : elle relie explicitement votre entité à ses identifiants externes (Wikidata QID, profils LinkedIn, Twitter/X, etc.), ce qui aide Google à consolider les informations provenant de sources différentes.
Signaux algorithmiques et consolidation des entités
| Signal | Rôle dans le Knowledge Graph | Priorité |
|---|---|---|
| Données structurées JSON‑LD | Déclaration explicite de l’entité et de ses propriétés | Haute |
| Concordance inter-sites | Même nom/URL sur plusieurs sources fiables | Haute |
| Identifiants externes (sameAs, QID) | Désambiguïsation et consolidation | Haute |
| Autorité des sources citantes | Wikipedia, presse nationale, sites gouvernementaux | Moyenne |
| Signaux comportementaux | Fréquence de recherche de l’entité | Faible/indirecte |
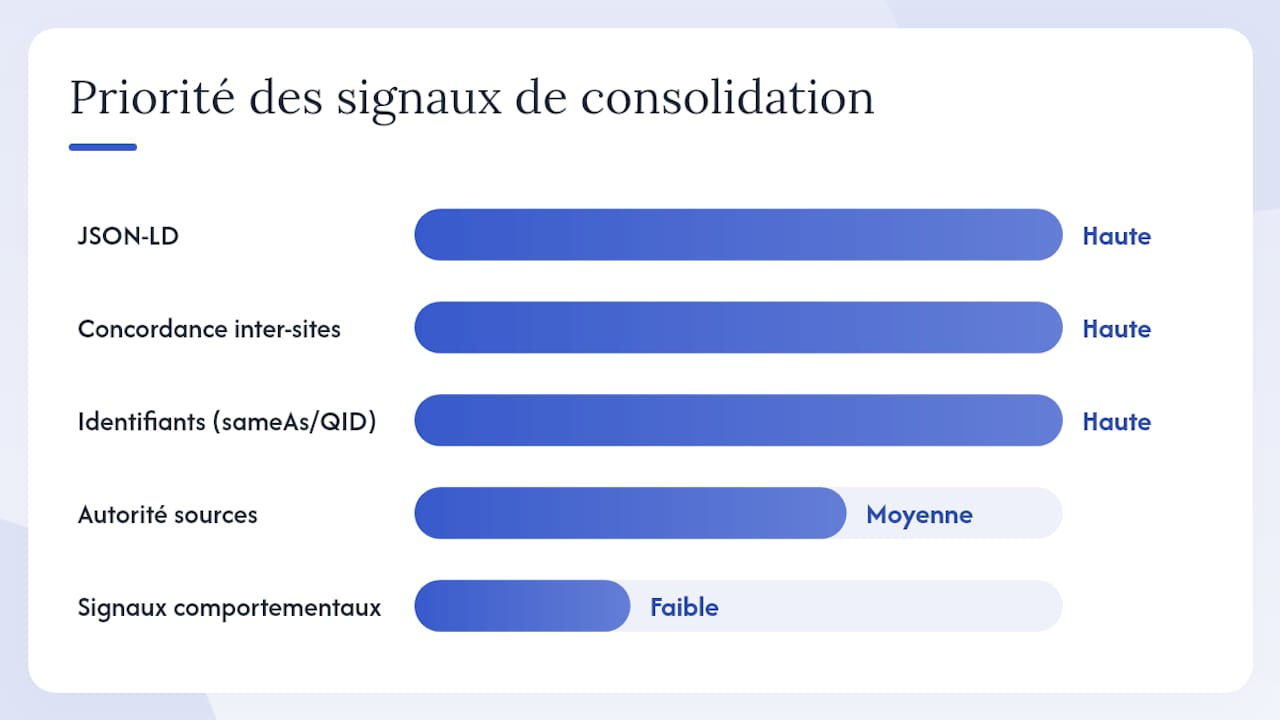
La consolidation des doublons est un problème courant : si votre marque apparaît sous plusieurs noms légèrement différents sur le web, Google peut créer plusieurs entités distinctes. Utiliser systématiquement le même nom canonique et les mêmes identifiants sameAs sur tous vos profils réduit ce risque.
Conseil de pro : Vérifiez si votre entité possède déjà un QID Wikidata en cherchant son nom sur wikidata.org avant de créer une nouvelle entrée. Créer un doublon Wikidata aggrave la confusion au lieu de la résoudre.
Comment revendiquer et gérer votre fiche info Google ?
Quand et comment un Knowledge Panel apparaît-il ?
Google génère les Knowledge Panels automatiquement à partir des données du graphe. Il n’existe pas de formulaire de soumission pour « créer » un panel : c’est Google qui décide, en fonction de la notoriété perçue de l’entité et de la qualité des données disponibles. Une PME locale peu documentée n’obtiendra pas de panel simplement en ajoutant du JSON‑LD sur son site.
La distinction entre présence dans le graphe et fiche revendiquée est souvent mal comprise. Avoir un panel non revendiqué signifie que Google affiche des informations sur votre entité, mais que vous n’avez pas de contrôle sur certains éléments modifiables. Revendiquer la fiche ne donne pas un contrôle total, mais permet de suggérer des corrections et d’ajouter des liens officiels.
Signaler une erreur ou demander une suppression
Pour signaler une information incorrecte, utilisez le lien « Suggérer une modification » directement dans le panel. Pour les cas sensibles — atteinte à la vie privée, informations médicales erronées, données personnelles — Google dispose d’une procédure de retrait spécifique accessible via son centre d’aide. Les délais de traitement varient et aucune garantie de modification n’est donnée.
Conseil de pro : Joignez systématiquement des URLs de sources fiables (presse nationale, site officiel, Wikidata) à chaque demande de modification. Une demande sans preuve externe a peu de chances d’aboutir.
Comment utiliser la Knowledge Graph Search API ?
Cas d’usage typiques
La Knowledge Graph Search API permet d’interroger le graphe de Google par programme pour récupérer des métadonnées sur des entités. Les cas d’usage les plus courants en contexte professionnel :
- Enrichissement automatique de bases de données internes (associer un nom d’entreprise à son QID et ses métadonnées)
- Désambiguïsation dans des pipelines de traitement du langage naturel
- Vérification d’entités dans des outils de veille ou de modération de contenu
- Alimentation d’assistants vocaux ou de chatbots avec des données factuelles vérifiées
Structure d’une requête et format de réponse
Une requête type ressemble à ceci (Python) :
import requests

API_KEY = "VOTRE_CLE_API"
query = "Zetaplus"
url = f"https://kgsearch.googleapis.com/v1/entities:search?query={query}&key={API_KEY}&limit=5&indent=True"

response = requests.get(url)
data = response.json()
La réponse retourne une liste d’éléments avec leur type schema.org (Organization, Person, Place…), leur score de pertinence, leur description et leurs identifiants. Le champ @id contient l’identifiant Knowledge Graph de l’entité, distinct du QID Wikidata.
| Paramètre API | Rôle | Valeur recommandée |
|---|---|---|
query |
Terme de recherche | Nom canonique de l’entité |
types |
Filtre par type schema.org | Organization, Person, etc. |
limit |
Nombre de résultats | 5 pour la désambiguïsation |
languages |
Langue des résultats | fr pour le contexte francophone |
indent |
Formatage JSON | True en développement |
Limitations pratiques
La couverture de l’API est inférieure à celle du graphe interne de Google : toutes les entités présentes dans les panels ne sont pas accessibles via l’API. Les quotas gratuits sont limités (100 requêtes par jour par défaut), et la latence peut atteindre plusieurs secondes pour des requêtes complexes. Pour des besoins à grande échelle, Wikidata offre une alternative sans quota via son API SPARQL.
Conseil de pro : Filtrez toujours par type (types=Organization) pour éviter les faux positifs. Une requête sur un nom d’entreprise sans filtre retourne souvent des personnes ou des lieux homonymes en premier.
Quelles sont les limites et critiques du Knowledge Graph ?
Sources d’erreurs courantes
Le Knowledge Graph agrège des données à grande échelle de façon automatique, ce qui génère des erreurs structurelles difficiles à corriger. La sur-indexation de pages SEO optimisées mais factuellement douteuses est un problème documenté : un site bien positionné peut devenir une source de référence pour le graphe, même si ses informations sont inexactes.
Les conflits entre sources sont fréquents pour les entités homonymes. Une personnalité française portant le même nom qu’une célébrité internationale peut se retrouver avec une fiche mélangeant les deux biographies. Les images sont particulièrement touchées : des photos incorrectes associées à une entité ont été signalées à plusieurs reprises dans la presse spécialisée.
« Les Knowledge Panels peuvent afficher des informations sans attribution explicite à une source. Cette absence de citation rend difficile pour l’entité concernée de comprendre d’où vient l’erreur et comment la corriger. »
Wikipedia, Knowledge Graph (Google))
Sujets sensibles et politique de retrait
Pour les sujets médicaux, civiques ou politiques, Google applique des politiques de contenu plus strictes. Des informations médicales erronées peuvent être retirées si elles présentent un risque pour les utilisateurs. Les données personnelles relevant du droit à l’oubli (RGPD en France) peuvent faire l’objet d’une demande de suppression via le formulaire dédié de Google, distinct du processus de modification standard.
Un cas emblématique reste celui des « featured snippets » erronés — des extraits de réponse directe tirés de sources peu fiables et affichés en position zéro. Bien que distincts du Knowledge Graph stricto sensu, ils illustrent le même risque : l’automatisation à grande échelle produit des erreurs que les systèmes manuels de vérification ne rattrapent pas toujours.
La leçon pratique pour les professionnels : surveiller activement ce que Google affiche sur votre entité, documenter les erreurs avec des preuves solides, et agir rapidement. Plus une information incorrecte reste affichée longtemps, plus elle se propage dans d’autres sources qui la reprennent, créant un cercle vicieux difficile à briser.
Checklist technique pour améliorer la reconnaissance de votre entité
Étapes priorisées par impact
-
Déployer JSON‑LD sur toutes les pages clés : page d’accueil, page « À propos », pages auteurs. Utilisez le type
OrganizationouPersonavec les champsname,url,logo,description,sameAs. Validez avec le testeur de données structurées de Google. -
Créer ou enrichir l’entrée Wikidata — vérifiez d’abord l’existence d’un QID. Si l’entité n’existe pas et répond aux critères de notoriété de Wikidata, créez une entrée avec des sources vérifiables. Ajoutez ensuite ce QID dans le champ
sameAsde votre JSON‑LD.
Conseil de pro : Pour les entités locales françaises, assurez-vous que votre fiche Google Business Profile est vérifiée et cohérente avec votre JSON‑LD. Google croise ces deux sources pour les entités locales, et une incohérence peut bloquer l’apparition du panel.
Points clés
Le Knowledge Graph repose sur la cohérence des données structurées, la présence dans des sources tierces fiables et la revendication active de la fiche info — trois leviers que tout SEO peut actionner dès aujourd’hui.
| Point | Détails |
|---|---|
| JSON‑LD et schema.org | Déployez le type Organization ou Person avec sameAs sur toutes les pages clés du site. |
| Wikidata comme pivot | Créez ou enrichissez un QID Wikidata et liez-le dans votre JSON‑LD pour aider Google à consolider l’entité. |
| Revendication de fiche | Revendiquez le Knowledge Panel dès son apparition pour pouvoir suggérer des corrections et ajouter des liens officiels. |
| Surveillance active | Vérifiez le panel mensuellement ; les Core Updates peuvent modifier les données affichées sans préavis. |
| Zetaplus | Accompagne les marques françaises sur l’audit, l’implémentation JSON‑LD, la gestion Wikidata et la revendication de panels. |
Le Knowledge Graph vu de l’agence : ce que les professionnels sous-estiment
La plupart des SEOs savent qu’il faut « faire du schema.org ». Beaucoup moins comprennent pourquoi ça ne suffit pas, et c’est là que les projets échouent.
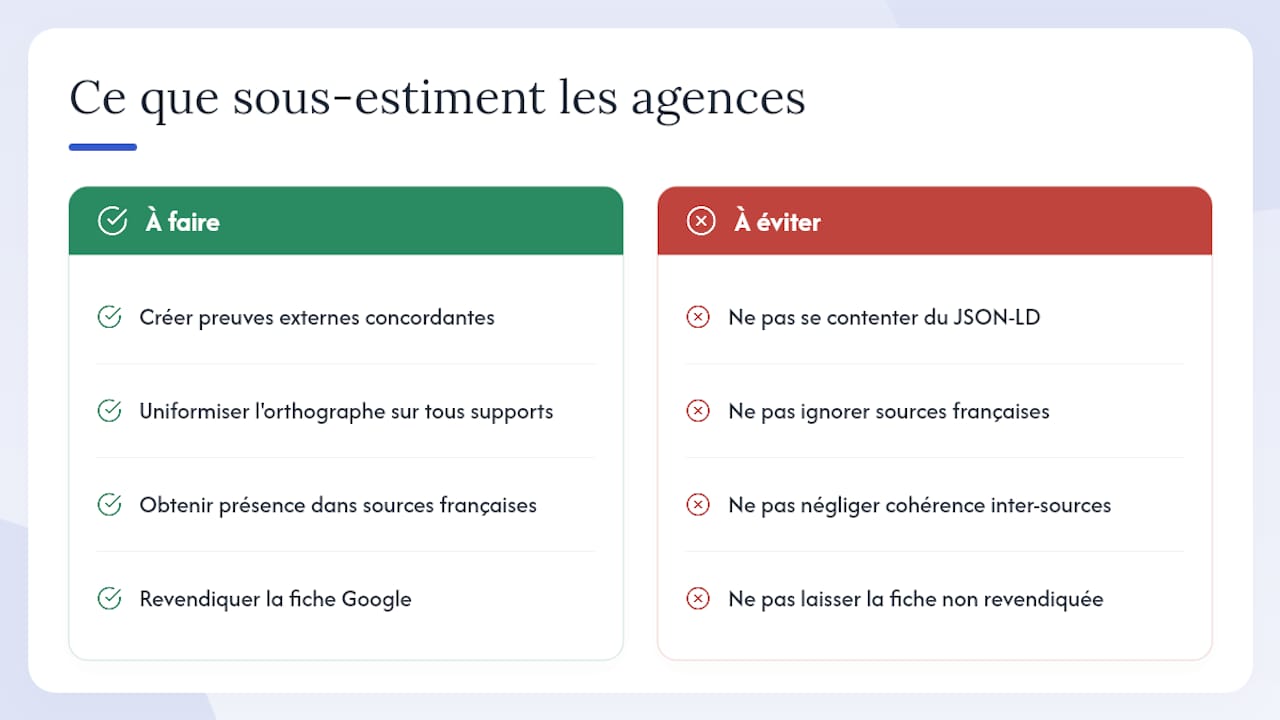
Le Knowledge Graph n’est pas un registre dans lequel on s’inscrit. C’est un système d’inférence qui décide, sur la base de signaux concordants, si une entité mérite d’être reconnue. Ajouter du JSON‑LD sur son site sans créer de preuves externes concordantes, c’est comme déposer un dossier de candidature sans références. Google lit le JSON‑LD, mais il vérifie ailleurs.
Ce que les professionnels sous-estiment systématiquement, c’est le poids de la cohérence inter-sources. Pas la quantité de sources, la cohérence. Un nom d’entreprise orthographié différemment sur LinkedIn, Wikidata et le site officiel suffit à créer deux entités distinctes dans le graphe. Résultat : un panel qui n’apparaît pas, ou pire, un panel qui mélange des informations de deux entités différentes.
L’autre angle mort concerne les entités francophones. Le Knowledge Graph est historiquement mieux documenté en anglais. Une marque française bien connue localement peut être quasi-invisible dans le graphe si elle n’a pas de présence dans des sources indexées en français par des éditeurs reconnus. La presse nationale, les annuaires professionnels français, les bases de données sectorielles — ces sources ont un poids que les SEOs francophones négligent au profit de tactiques pensées pour le marché anglophone.
Enfin, la revendication de fiche est souvent traitée comme une formalité. Elle ne l’est pas. C’est le seul levier direct que Google offre aux titulaires d’entité pour corriger des informations erronées. Ne pas l’activer, c’est laisser Google décider seul de ce qu’il affiche sur vous.
Zetaplus vous accompagne sur la visibilité de votre entité
Avoir une présence dans le Knowledge Graph n’est pas réservé aux grandes marques. Les PME et startups françaises qui structurent correctement leurs données dès le départ gagnent une visibilité que leurs concurrents mettent des années à obtenir.

Zetaplus propose un accompagnement complet : audit de la présence actuelle dans le graphe, production des fichiers JSON‑LD adaptés à votre structure, création ou enrichissement de l’entrée Wikidata, et gestion du processus de revendication de panel. Contrairement à une approche DIY qui prend des mois à porter ses fruits, notre méthode s’appuie sur une implémentation cohérente sur l’ensemble de votre écosystème digital dès le départ. Le résultat concret : une entité consolidée, un panel qui affiche les bonnes informations, et une visibilité accrue dans les résultats de recherche sémantique.
Vous souhaitez savoir où en est votre entité dans le graphe ? Contactez Zetaplus pour un audit de votre présence actuelle et une feuille de route priorisée.
Ressources officielles et lectures recommandées
Les sources ci-dessous couvrent l’essentiel de ce dont vous avez besoin pour aller plus loin, de la documentation développeur aux standards techniques.
- Introducing the Knowledge Graph: things, not strings — L’annonce originelle de 2012 par Google. Utile pour comprendre les objectifs fondateurs et la logique de désambiguïsation.
- How Google’s Knowledge Graph works (Google Support) — La référence officielle pour comprendre les sources, le processus de revendication et les politiques de modification.
- Google’s Knowledge Graph and Knowledge Panels — Explication détaillée du fonctionnement des panels, des options de feedback et des politiques de contenu.
- schema.org — Le vocabulaire de référence pour annoter vos entités. Consultez en priorité les types
Organization,PersonetLocalBusiness. - json-ld.org — Documentation technique sur le format JSON‑LD, avec des exemples de syntaxe et des outils de validation.
- Wikidata — La base de données structurées ouverte qui sert de pivot pour les identifiants d’entité. Indispensable pour créer ou vérifier un QID.
| Ressource | Usage principal |
|---|---|
| Google Support (Knowledge Panels) | Revendication, modification, signalement d’erreurs |
| schema.org | Référence des types et propriétés pour JSON‑LD |
| json-ld.org | Syntaxe et validation du format de données structurées |
| Wikidata | Création/enrichissement de QID, données ouvertes |
| Wikipedia (Knowledge Graph) | Contexte historique et critiques documentées |
Questions fréquentes
Qu’est-ce qu’un Knowledge Panel Google ?
Un Knowledge Panel est une fiche d’information affichée dans les résultats Google pour une entité reconnue (personne, marque, lieu). Il est généré automatiquement à partir des données du Knowledge Graph.
Comment faire apparaître un Knowledge Panel pour ma marque ?
Il n’existe pas de soumission directe. Il faut atteindre une masse critique de données concordantes : JSON‑LD sur le site, entrée Wikidata, mentions dans des sources fiables, et profils officiels cohérents.
Peut-on modifier les informations affichées dans un Knowledge Panel ?
Oui, partiellement. En revendiquant la fiche via Google Search, vous pouvez suggérer des corrections et ajouter des liens officiels. Google reste libre d’accepter ou de refuser chaque modification.
À quoi sert la Knowledge Graph Search API ?
Elle permet d’interroger le graphe par programme pour récupérer des métadonnées sur des entités — utile pour l’enrichissement de bases de données, la désambiguïsation ou les pipelines de traitement automatique du langage.
Wikidata est-il indispensable pour apparaître dans le Knowledge Graph ?
Pas indispensable, mais fortement recommandé. Un QID Wikidata fournit un identifiant stable que Google utilise pour consolider les informations provenant de sources différentes, ce qui accélère la reconnaissance de l’entité.